Ngulik: Pemburu Kata Slang
Alat NLP yang berjalan di laptop untuk menemukan kata slang dan istilah meme Indonesia dari komentar publik. Mulai dari beberapa kata kunci, Ngulik mengumpulkan komentar, menyaring spam, lalu mengusulkan kata-kata baru. Manusia yang memutuskan, dan kata yang disetujui menjadi titik awal putaran berikutnya.
- Python
- NLP
- TF-IDF
- SQLite
- CLI
- YouTube Data API
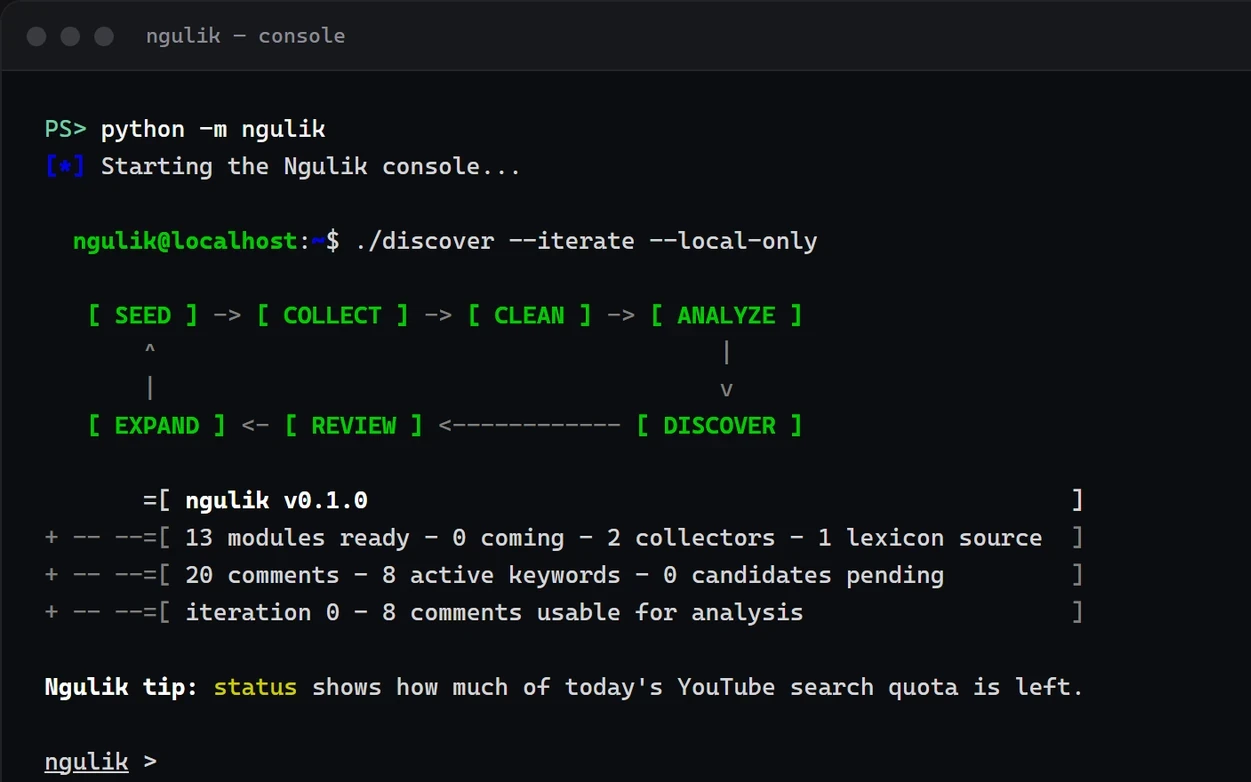
Bahasa internet bergerak lebih cepat daripada kamus. Kata yang hari ini ramai di kolom komentar bisa belum punya definisi di mana pun. Ngulik saya bangun untuk menangkap kata-kata itu, dari data publik, langsung di laptop sendiri.
Namanya diambil dari kata ngulik: mengutak-atik sesuatu sampai paham cara kerjanya. Alatnya melakukan hal yang sama pada bahasa. Ia mulai dari beberapa kata yang sudah Anda kenal, lalu menggali komentar di sekitarnya untuk menemukan kata-kata yang belum Anda kenal.
01 — Masalahnya
Kata kunci cepat basi
Kalau hanya mencari kata yang sudah diketahui, kata baru tidak akan pernah ketemu.
Komentar itu berantakan
Singkatan, huruf berulang ("bagusssss"), ejaan campur, dan slang yang terus berganti.
Banyak sampah
Promo nomor WA, deretan link, copypasta dari banyak akun, dan komentar yang sama persis.
02 — Cara kerjanya
Ngulik bekerja dalam putaran. Setiap putaran menghasilkan kata kunci baru, dan kata itu dipakai untuk putaran berikutnya.
- 01 SeedAnda memberi beberapa kata awal, misalnya "gabut" dan "mager".
- 02 CollectKomentar publik dikumpulkan dari YouTube (lewat API resmi) atau dari berkas CSV/JSON Anda sendiri.
- 03 CleanTeks dirapikan: huruf kecil, link dibuang, slang dinormalisasi. Spam ditandai beserta alasannya, dan duplikat dikenali, termasuk yang hanya beda sedikit.
- 04 AnalyzeEmpat analisis dijalankan: kata paling sering, frasa 2–3 kata, kata yang paling khas (TF-IDF), dan kata yang sering muncul berdekatan (co-occurrence).
- 05 DiscoverSetiap kata diberi skor dari empat sinyal tadi. Yang paling menjanjikan diusulkan sebagai kandidat.
- 06 ReviewAnda melihat kandidat beserta contoh komentar aslinya, lalu memilih: setujui, tolak, atau lewati.
- 07 ExpandKata yang disetujui menjadi seed baru, dan putaran dimulai lagi.
03 — Yang menarik di baliknya
Konsol ala Metasploit
Selain perintah biasa, Ngulik punya konsol interaktif dengan pola use → set → run, terinspirasi dari msfconsole. Setiap tahap adalah modul yang bisa dipilih dan diatur.
TF-IDF ditulis sendiri
Tanpa pandas atau scikit-learn. Tokenizer bawaan library bentrok dengan normalisasi slang Bahasa Indonesia, jadi TF-IDF dan co-occurrence (PMI) ditulis manual. Dependensinya cuma tiga paket kecil.
Duplikat yang "hampir sama"
Selain yang identik, komentar yang nyaris sama dikenali dengan SimHash 64-bit dan jarak Hamming.
Hemat kuota YouTube
Hasil pencarian video disimpan ke cache. Mengambil komentar dari video tertentu tidak memakai jatah pencarian sama sekali. Kalau kuota habis di tengah jalan, data yang sudah terkumpul tetap aman.
Satu berkas SQLite
Semua data ada di satu berkas lokal. Tidak butuh server. Aman diulang: komentar yang sama tidak tersimpan dua kali.
Data mentah tidak bisa diubah
Sebuah trigger di database menolak perubahan pada teks asli komentar, sehingga setiap hasil analisis selalu bisa dilacak kembali ke sumbernya.
04 — Privasi dan etika
Alat pengumpul komentar bisa dengan mudah berubah menjadi alat pengintai. Ngulik sengaja dirancang agar tidak ke arah sana.
- Nama tampilan komentator tidak pernah disimpan. ID channel juga tidak, kecuali pengguna sengaja menyalakannya.
- Setiap kata baru wajib lewat keputusan manusia. Tidak ada yang otomatis menjadi kata kunci.
- Saat mengambil kamus slang online, Ngulik mematuhi robots.txt, memberi jeda 2 detik antar-permintaan, dan mengaku jujur sebagai "Ngulik".
- Entri kamus tentang orang sungguhan dilewati, dan nama kontributornya tidak pernah dibaca.
- Tujuannya memahami pola bahasa, bukan melacak atau menarget individu.
05 — Status
Versi 0.1.0 (alpha), open source dengan lisensi MIT. Sekitar 7.200 baris Python dengan 58 test otomatis yang lolos. Screenshot di halaman ini diambil dari Ngulik yang dijalankan dengan data contoh bawaan (20 komentar). Penemuan kata baru baru terasa hasilnya pada ratusan hingga ribuan komentar, jadi itulah langkah berikutnya: menjalankannya pada data yang lebih besar.